
Contents — find the section you need
Los métodos 3D neuronales aprenden una representación de la escena a partir de múltiples imágenes y poses de cámara, y luego renderizan una imagen desde un punto de vista no capturado. Mientras que la SfM estima principalmente poses y puntos dispersos, y la MVS reconstruye principalmente geometría densa, el 3D neuronal también modela cómo se ve una escena desde una posición y dirección de visualización.
En resumen
-
NeRF representa una escena como una función que devuelve densidad y radiancia a partir de la posición y la dirección de visualización; 3D Gaussian Splatting optimiza muchos elementos gaussianos 3D explícitos.
-
Reproducir bien las vistas de entrenamiento no prueba que las vistas o la geometría no vistas sean correctas.
-
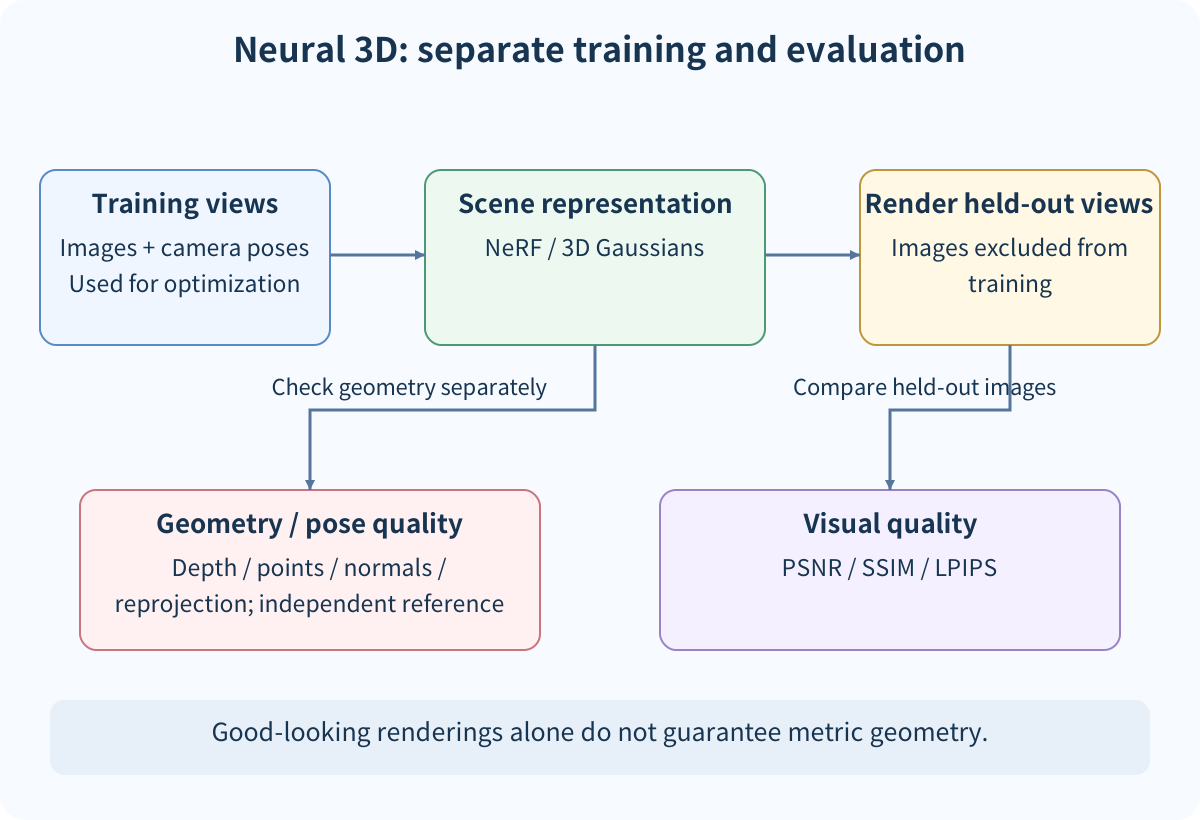
Separe las métricas de imagen, como PSNR/SSIM, de la evaluación geométrica de profundidad, puntos, normales y poses. La síntesis de vistas novedosas no es una prueba de precisión de la exploración.
Opciones de representación
NeRF evalúa (\sigma,\mathbf{c})=F_\theta(\mathbf{x},\mathbf{d}) en muestras a lo largo de los rayos de la cámara y utiliza renderizado volumétrico para formar una imagen. El entrenamiento minimiza la diferencia entre las imágenes renderizadas y de entrada. El splatting gaussiano 3D proyecta gaussianas con posición, covarianza, opacidad y color, y optimiza estos elementos a partir de puntos dispersos.
| Representación | Ventajas | Advertencias |
|---|---|---|
| Familia NeRF | Campo de radiancia continuo y apariencia dependiente de la vista | Muchas muestras de rayos; el entrenamiento y el renderizado dependen de la configuración |
| Splatting gaussiano 3D | Los elementos proyectados explícitos se pueden renderizar rápidamente | Valida la densidad, la geometría no visible y los objetos dinámicos por separado |
| Malla / MVS | La geometría de la superficie es explícita y fácil de inspeccionar | Sensible a reflejos, oclusiones, agujeros y texturas débiles |
Separación de vistas de entrenamiento y evaluación
Renderizar cada imagen de entrada utilizada para el entrenamiento solo mide la reconstrucción de las vistas observadas. No establece la interpolación en regiones no vistas. Divide las imágenes o la trayectoria de la cámara en vistas de entrenamiento, validación y reserva, y fija el espaciado entre vistas, la superposición, los objetos en movimiento y la fuente de la pose de la cámara. Si se estiman las poses, registra también su incertidumbre.
PSNR, SSIM y LPIPS pueden medir la similitud de las imágenes, pero miden la apariencia. La evaluación geométrica debe comparar por separado la profundidad, los puntos, las normales, las poses de la cámara y el error de reproyección. Una representación borrosa puede mejorar la puntuación de una imagen, pero coloca incorrectamente una pared o una estructura delgada.
Condiciones de fallo comunes
-
Los espejos, las superficies transparentes, los reflejos y la iluminación cambiante invalidan la suposición de que un punto tiene una apariencia consistente.
-
Las regiones fuera de la trayectoria de entrenamiento o ocultas por oclusión pueden parecer plausibles sin pruebas sólidas.
-
Las personas, vehículos o plantas en movimiento, tratados como geometría estática, pueden crear imágenes fantasma y superficies duplicadas.
- Si las poses o la escala de SfM son inestables, las imágenes renderizadas por sí solas no permiten identificar la causa.
Resumen
Neural 3D aprende una representación de escena dependiente de la vista a partir de imágenes y poses. NeRF y 3D Gaussian Splatting utilizan diferentes representaciones y estrategias de renderizado, pero ambas requieren una clara separación entre la reconstrucción de la vista de entrenamiento y la generalización de la vista de prueba. Registre la calidad visual, la geometría, el error de pose, el contenido dinámico y las divisiones de vista de forma independiente antes de interpretar un resultado.
¿Un PSNR alto en la vista de entrenamiento demuestra que la geometría 3D es correcta?
No. Compruebe por separado las vistas no vistas, las métricas de profundidad o nube de puntos y el error de pose de la cámara.
## Referencias - [Mildenhall et al., NeRF: Representación de escenas como campos de radiancia neuronal para la síntesis de vistas](https://arxiv.org/abs/2003.08934) - [Kerbl et al., Distribución gaussiana 3D para la renderización de campos de radiancia en tiempo real](https://arxiv.org/abs/2308.04079)
Comentarios
Inicia sesión para continuar.
Todavía no hay datos.