
Contents — find the section you need
신경망 3D 기법은 여러 이미지와 카메라 포즈를 이용하여 장면 표현을 학습한 후, 촬영되지 않은 시점에서 이미지를 렌더링합니다. SfM(구조적 모델링)은 주로 포즈와 희소한 점들을 추정하고, MVS(다중 시점 렌더링)는 주로 밀집된 기하학적 구조를 재구성하는 반면, 신경망 3D는 특정 위치와 시야 방향에서 장면이 어떻게 보이는지까지 모델링합니다.
요약
-
NeRF(Neural Enhancement Function)는 위치와 시야 방향에 따른 밀도와 휘도를 반환하는 함수로 장면을 표현합니다. 3D 가우시안 스플래팅(3D Gaussian Splatting)은 여러 개의 명시적인 3D 가우시안 요소를 최적화합니다.
-
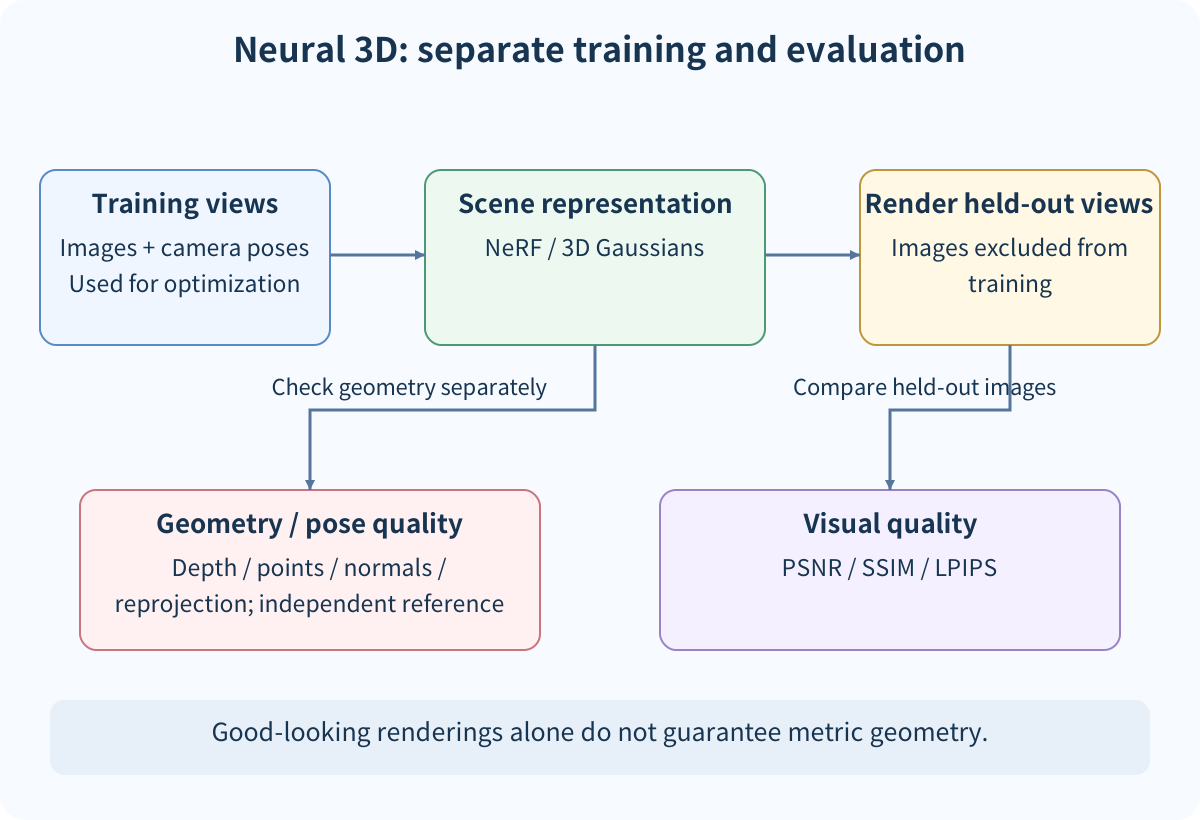
학습 시점을 잘 재현한다고 해서 미지의 시점이나 기하학적 구조가 정확하다는 것을 보장하는 것은 아닙니다.
-
PSNR/SSIM과 같은 이미지 메트릭을 깊이, 점, 법선, 포즈 등의 기하학적 평가와 분리하여 고려해야 합니다. 새로운 시점 합성이 조사 정확도를 증명하는 것은 아닙니다.
표현 방식 선택
NeRF는 카메라 광선을 따라 샘플링하여 (\sigma,\mathbf{c})=F_\theta(\mathbf{x},\mathbf{d})을 평가하고 볼륨 렌더링을 사용하여 이미지를 생성합니다. 학습은 렌더링된 이미지와 입력 이미지 간의 차이를 최소화합니다. 3D 가우시안 스플래팅은 위치, 공분산, 불투명도 및 색상을 가진 가우시안을 투영하고 희소한 지점에서 시작하여 이러한 요소를 최적화합니다.
| 표현 방식 | 장점 | 주의 사항 |
|---|---|---|
| NeRF 계열 | 연속적인 복사 휘도 필드 및 시점 의존적 외관 | 많은 광선 샘플; 학습 및 렌더링은 설정에 따라 달라짐 |
| 3D 가우시안 스플래팅 | 명시적으로 투영된 요소는 빠른 렌더링 가능 | 밀도, 보이지 않는 형상 및 동적 객체를 개별적으로 검증 가능 |
| 메시/MVS | 표면 형상이 명시적이고 검사하기 쉬움 | 반사, 가려짐, 구멍 및 약한 텍스처에 민감함 |
학습 및 평가 뷰 분할
학습에 사용되는 모든 입력 이미지를 렌더링하는 것은 관찰된 뷰의 재구성만을 측정합니다. 이는 관찰되지 않은 영역에 대한 보간을 수행하지 않습니다. 이미지 또는 카메라 궤적을 학습, 검증 및 홀드아웃 뷰로 분할하고, 뷰 간격, 겹침, 움직이는 객체 및 카메라 포즈 소스를 고정합니다. 포즈를 추정하는 경우 불확실성도 함께 기록합니다.
PSNR, SSIM 및 LPIPS는 이미지 유사도를 측정할 수 있지만, 외관만을 측정합니다. 기하학적 평가는 깊이, 점, 법선, 카메라 포즈 및 재투영 오차를 개별적으로 비교해야 합니다. 흐릿한 표현이 이미지 점수를 향상시킬 수 있지만, 벽이나 얇은 구조물을 잘못 배치할 수도 있습니다.
일반적인 오류 조건
-
거울, 투명한 표면, 반사 및 변화하는 조명은 점의 일관된 외관을 가정하는 것을 방해합니다.
-
학습 궤적 외부 영역이나 가려진 영역은 확실한 증거 없이 그럴듯하게 보일 수 있습니다.
-
움직이는 사람, 차량 또는 식물을 정적인 형상으로 처리하면 고스트 현상이나 중복된 표면이 발생할 수 있습니다.
-
SfM 포즈나 스케일이 불안정할 경우, 렌더링된 이미지만으로는 원인을 파악할 수 없습니다.
요약
Neural 3D는 이미지와 포즈를 기반으로 시점에 따라 달라지는 장면 표현을 학습합니다. NeRF와 3D Gaussian Splatting은 서로 다른 표현 방식과 렌더링 전략을 사용하지만, 둘 다 학습 뷰 재구성과 검증 뷰 일반화 간의 명확한 분리가 필요합니다. 결과를 해석하기 전에 시각적 품질, 기하학적 형상, 포즈 오류, 동적 콘텐츠, 뷰 분할을 각각 독립적으로 기록해야 합니다.
학습 뷰 PSNR이 높다고 해서 3D 기하학적 형상이 정확하다고 할 수 있나요?
아니요.
홀드아웃 뷰, 깊이 또는 포인트 클라우드 메트릭, 카메라 포즈 오류를 각각 확인하세요.
댓글
먼저 로그인해 주세요.
아직 데이터가 없습니다.