
Contents — find the section you need
Neuronale 3D-Methoden lernen eine Szenenrepräsentation aus mehreren Bildern und Kamerapositionen und rendern anschließend ein Bild aus einem nicht erfassten Blickwinkel. Während SfM primär Positionen und wenige Punkte schätzt und MVS primär die dichte Geometrie rekonstruiert, modelliert neuronales 3D zusätzlich, wie eine Szene aus einer bestimmten Position und Blickrichtung aussieht.
Kurz zusammengefasst
-
NeRF repräsentiert eine Szene als Funktion, die Dichte und Strahlungsdichte in Abhängigkeit von Position und Blickrichtung zurückgibt; 3D Gaussian Splatting optimiert viele explizite 3D-Gauß-Elemente.
-
Die gute Reproduktion von Trainingsansichten beweist nicht die Korrektheit unbekannter Ansichten oder Geometrien.
-
Bildmetriken wie PSNR/SSIM sollten von der geometrischen Bewertung von Tiefe, Punkten, Normalen und Positionen getrennt werden. Die Synthese neuer Ansichten ist kein Beweis für die Genauigkeit von Vermessungen.
Darstellungsoptionen
NeRF wertet (\sigma,\mathbf{c})=F_\theta(\mathbf{x},\mathbf{d}) an Abtastpunkten entlang der Kamerastrahlen aus und verwendet Volumenrendering zur Bilderzeugung. Das Training minimiert die Differenz zwischen gerendertem und Eingabebild. 3D Gaussian Splatting projiziert Gaußfunktionen mit Position, Kovarianz, Deckkraft und Farbe und optimiert diese Elemente ausgehend von wenigen Punkten.
| Darstellung | Stärke | Einschränkung |
|---|---|---|
| NeRF-Familie | Kontinuierliches Strahlungsfeld und ansichtsabhängiges Erscheinungsbild | Viele Strahlabtastpunkte; Training und Rendering hängen von der Konfiguration ab |
| 3D Gaussian Splatting | Explizit projizierte Elemente ermöglichen schnelles Rendern | Dichte, unsichtbare Geometrie und dynamische Objekte werden separat validiert |
| Mesh / MVS | Oberflächengeometrie ist explizit und leicht zu überprüfen | Empfindlich gegenüber Reflexionen, Verdeckungen, Löchern und schwacher Textur |
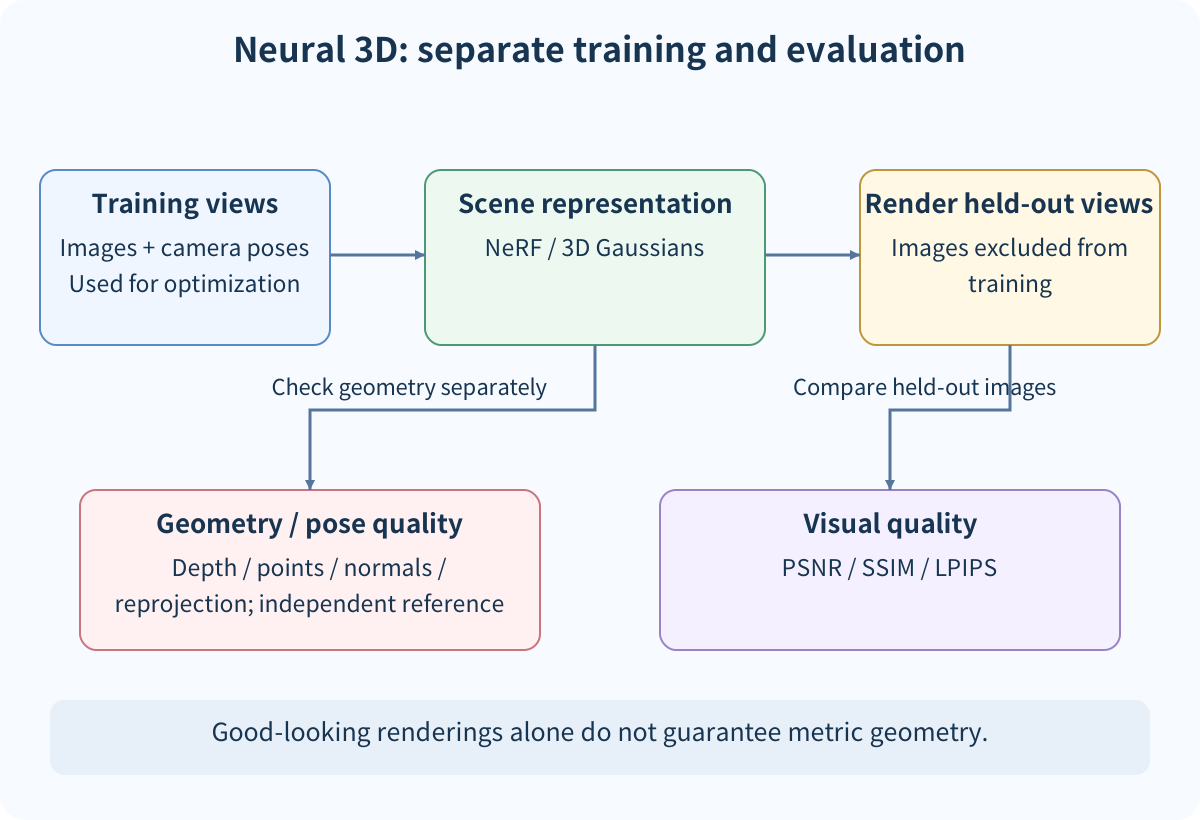
Trainings- und Evaluierungsansichten trennen
Das Rendern jedes Eingabebildes für das Training misst lediglich die Rekonstruktion der beobachteten Ansichten. Es ermöglicht keine Interpolation in nicht sichtbare Bereiche. Teilen Sie Bilder oder eine Kameratrajektorie in Trainings-, Validierungs- und Testansichten auf und korrigieren Sie den Ansichtsabstand, die Überlappung, bewegte Objekte und die Quelle der Kamerapose. Falls Posen geschätzt werden, erfassen Sie auch deren Unsicherheit.
PSNR, SSIM und LPIPS können zwar die Bildähnlichkeit messen, erfassen aber das Erscheinungsbild. Die geometrische Evaluierung sollte Tiefe, Punkte, Normalen, Kameraposen und Reprojektionsfehler separat vergleichen. Eine unscharfe Darstellung kann die Bildbewertung verbessern, während eine Wand oder eine dünne Struktur falsch platziert wird.
Häufige Fehlerbedingungen
-
Spiegel, transparente Oberflächen, Reflexionen und wechselnde Beleuchtung verletzen die Annahme, dass ein Punkt ein konsistentes Erscheinungsbild hat.
-
Bereiche außerhalb der Trainingstrajektorie oder verdeckt durch Okklusion können ohne starke Beweise plausibel erscheinen.
-
Bewegte Personen, Fahrzeuge oder Pflanzen, die als statische Geometrie behandelt werden, können Geisterbilder und doppelte Oberflächen erzeugen.
Wenn SfM-Posen oder -Skalierungen instabil sind, kann die Ursache anhand gerenderter Bilder allein nicht ermittelt werden.
Zusammenfassung
Neural 3D lernt eine ansichtsabhängige Szenenrepräsentation aus Bildern und Posen. NeRF und 3D Gaussian Splatting verwenden unterschiedliche Repräsentationen und Rendering-Strategien, erfordern aber beide eine klare Trennung zwischen der Rekonstruktion der Trainingsansicht und der Generalisierung der gehaltenen Ansicht. Visuelle Qualität, Geometrie, Posenfehler, dynamische Inhalte und Ansichtsaufteilungen sollten unabhängig voneinander erfasst werden, bevor ein Ergebnis interpretiert wird.
Beweist ein hoher PSNR-Wert der Trainingsansicht, dass die 3D-Geometrie korrekt ist?
Nein. Überprüfen Sie die zurückgehaltenen Ansichten, Tiefen- oder Punktwolkenmetriken und den Kamerapositionsfehler separat.
Kommentare
Bitte zuerst anmelden.
Noch keine Einträge.