
Contents — find the section you need
神经3D方法从多幅图像和相机姿态中学习场景表示,然后从未拍摄的视角渲染图像。SfM主要估计姿态和稀疏点,MVS主要重建稠密几何,而神经3D还对场景在特定位置和视角下的外观进行建模。
简述
-
NeRF将场景表示为一个函数,该函数根据位置和视角返回密度和辐射度;3D高斯散射优化了许多显式的3D高斯元素。
-
能够很好地重现训练视图并不能证明未见过的视图或几何形状是正确的。
-
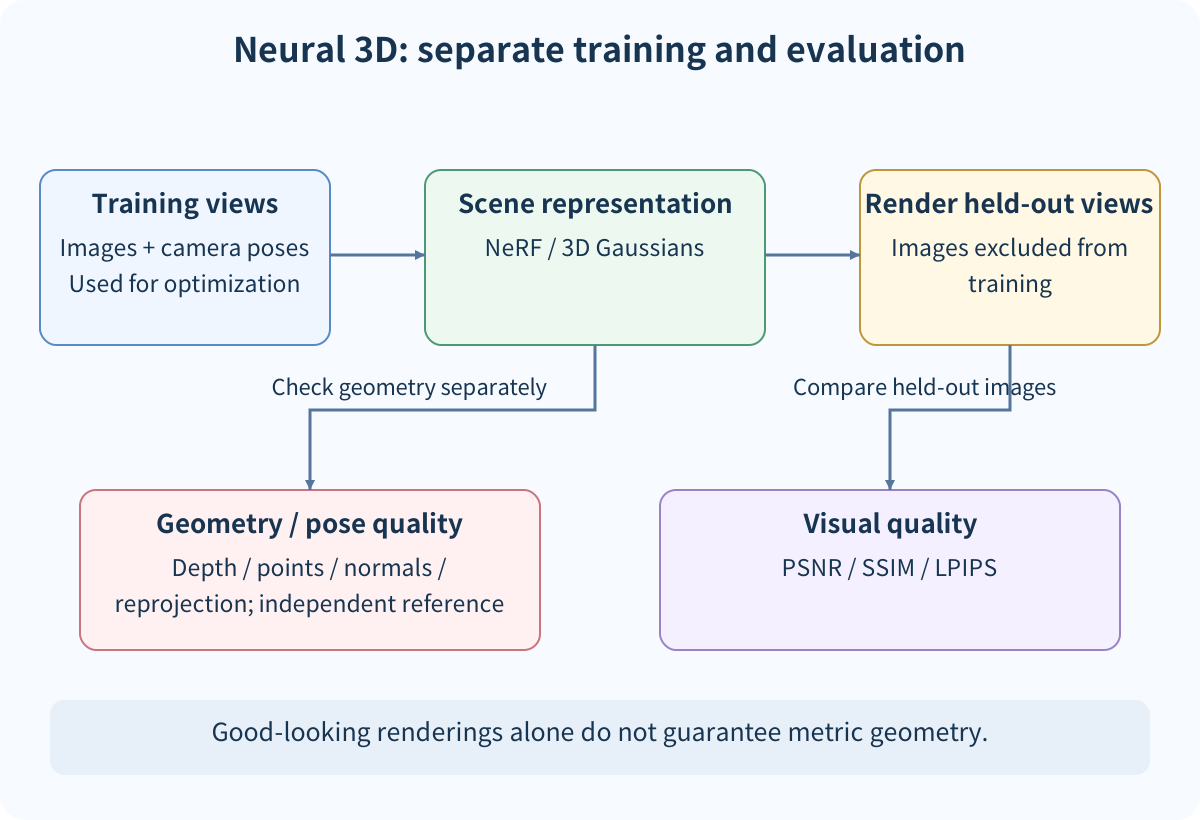
将图像评价指标(例如PSNR/SSIM)与深度、点、法线和姿态的几何评估分开。新视图合成并不能证明调查精度。
表示选择
NeRF 沿相机光线采样,并使用体绘制生成图像。训练的目标是最小化渲染图像与输入图像之间的差异。3D 高斯散射投影使用位置、协方差、不透明度和颜色等参数投影高斯函数,并从稀疏点开始优化这些元素。
| 表示 | 优势 | 注意事项 |
|---|---|---|
| NeRF 系列 | 连续的辐射场和视角相关的外观 | 光线采样数量多;训练和渲染取决于设置 |
| 3D 高斯散射 | 显式投影元素可以快速渲染 | 分别验证密度、未见几何体和动态对象 |
| 网格/MVS | 表面几何体清晰且易于检查 | 对反射、遮挡、孔洞和弱纹理敏感 |
划分训练和评估视图
仅渲染用于训练的每个输入图像只能衡量已观测视图的重建效果,而无法建立对未观测区域的插值。应将图像或相机轨迹划分为训练视图、验证视图和保留视图,并固定视图间距、重叠区域、移动物体以及相机位姿来源。如果位姿是估计的,则还应记录其不确定性。
PSNR、SSIM 和 LPIPS 可以衡量图像相似度,但它们衡量的是外观。几何评估应分别比较深度、点、法线、相机位姿和重投影误差。模糊的图像表示可能会提高图像得分,但错误地放置墙壁或薄结构则可能导致结果不准确。
常见失效情况
-
镜子、透明表面、反射和光照变化会打破点具有一致外观的假设。
-
训练轨迹之外或被遮挡的区域可能看起来很合理,但缺乏强有力的证据。
-
将移动的人、车辆或植物视为静态几何体可能会产生重影和重复表面。
-
如果 SfM 的姿态或尺度不稳定,仅凭渲染图像无法确定原因。
总结
神经 3D 从图像和姿态中学习与视角相关的场景表示。NeRF 和 3D 高斯散射使用不同的表示和渲染策略,但两者都要求明确区分训练视图的重建和保留视图的泛化。在解释结果之前,请分别记录视觉质量、几何形状、姿态误差、动态内容和视图分割情况。
高训练视图 PSNR 是否证明 3D 几何形状正确?
否。
分别检查保留视图、深度或点云指标以及相机位姿误差。
评论
请先登录。
暂无数据。