目次 — 知りたいところから読む
入力を変えて確かめる
実験パネルを開き、実行を押すとPythonを読み込みます。停止と初期値へのリセットができます。結果はこの端末内で計算します。Pythonのインストールは不要です。
下にあるローカル実行の手順は、配布ソースを再現するための任意の手順です。ブラウザ実験には不要です。
前提と読み方
前提知識 合成Labはブラウザだけで利用できる。任意の実接続測定にはOllamaとHTTP・Pythonの基本が必要。
実装・実験 · 本文の条件と確認項目に沿って、計算例や比較表を追う。
「毎秒何token出るか」だけでは、質問を送ってから待たされる時間は分からない。ローカルLLMの比較では、最初の回答、生成中の速度、最後までの時間、メモリを別々に記録する。本記事は測定手順とクライアントコードを提供する。実モデルの性能測定や機種別ランキングは行っていない。
ブラウザで合成ストリームの時間を比べる
Pythonやモデルをインストールせず、合成イベントの到着時刻をブラウザで比較できる。既存クライアントの時間計算をそのまま使うが、Ollamaへの接続やハードウェアの測定は行わない。時間のLabを開く。
最初の到着までの遅延、思考時間(「思考の後に回答」の条件だけ)、回答断片の到着間隔を変える。図は思考・回答・完了通知・エラー・空の断片を分けて示す。同時刻の点は重なるが、データ表には全イベントが残る。Aに保存して条件を変え、Bを実行すると比較できる。「到着だけを遅らせる」では、サーバーのカウンターを固定したままクライアント側の時間が変わる。
教材の設定は回答3断片、その1間隔後の完了通知、終了後50 msのクライアント処理である。思考ありでは回答前に思考イベントを追加する。回答なし・完了通知で回答の条件も、合成の完了通知時刻は同じ規則で決める。成功例の生成数20 tokenと生成時間2秒(10 token/s)は仮定した入力であり、生成処理の物理モデルや実測値ではない。3断片が20 tokenに対応するという推定でもない。生成時間ゼロの条件では速度は未取得となる。到着の操作から実際のコールドスタート、キャッシュ、ネットワークの性能は予測できない。
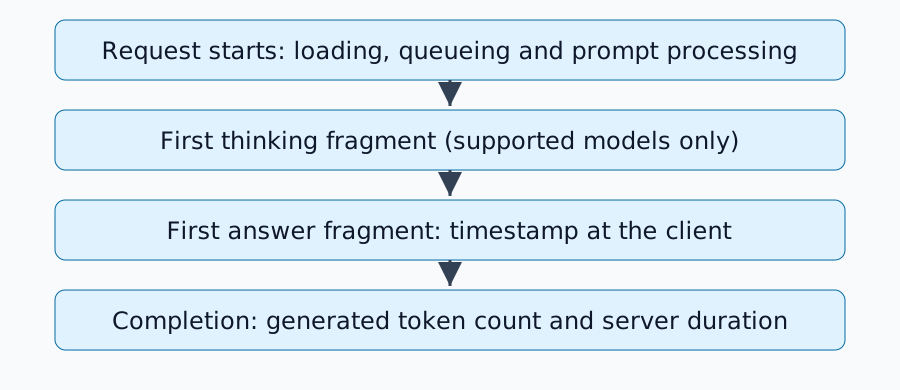
TTFCは最初の空でない回答までの時間であり、完了通知に回答が初めて含まれる場合も数える。思考の開始は別の指標である。回答なしならTTFCは未取得、途中切断やAPIエラーならストリーム失敗となり成功時の指標はすべて未取得になる。「—」はゼロではない。サーバーの生成時間だけでは到着軸上の生成区間は分からないため、別の値として示す。ブラウザ自身の計算時間も推論性能ではない。
ブラウザ用アダプターと変更していないクライアントのコピーを公開している。両方を保存すれば、この合成例を任意でローカル再現できる。後述の実接続手順は自分のモデルを使う別の任意実験である。このLabはメモリ、回答品質、厳密な最初のtokenの遅延、機種の処理性能を測定しない。
測定する時間を定義する
TTFTは通常、要求から最初のtokenまでの時間を指す。ただしHTTPのストリーム断片が必ず1tokenとは限らない。このコードは最初の空でないresponse断片までをTTFC(最初の回答内容までの時間)として記録する。thinkingが別に返る場合はその最初の時刻も別列にする。待ち行列、モデル読込、入力処理、通信が含まれるクライアント指標である。
生成速度はサーバーが返す生成token数と生成時間から計算する。Ollamaの時間フィールドはnsなので、秒への変換が必要だ。Generate APIの定義を2026-09-07に確認した。
この値は要求全体の処理速度ではない。また、モデルごとにtokenizerが違うため、token/sだけで日本語の回答量や品質を公平に比較できるとは限らない。
実行前に固定する条件
モデル名だけでなくダイジェスト、量子化、Ollamaのバージョン、CPU/GPU、RAM/VRAM、電力制限、並列要求数、プロンプトを保存する。同じ文章でも入力token数が違うので、返されたカウントも残す。モデル未常駐の最初の要求と、常駐後の要求を混ぜない。
同じプロンプトの反復ではキャッシュが効くことがある。「常駐済み・同一プロンプト反復」と「常駐済み・新しい入力」は別の試験にする。実行順を固定しすぎると温度やバックグラウンド処理の偏りも入るため、比較順も記録する。
任意: 実際の接続先を測定するコード
llm_benchmark.pyと、自分が比較したい文章を入れたprompt.txtを同じフォルダに置く。Python標準ライブラリだけを使う。次のYOUR_MODELはインストール済みのモデル名に置き換える。
python3 llm_benchmark.py --model YOUR_MODEL --prompt-file prompt.txt --runs 5 > runs.jsonl
既定の接続先は127.0.0.1:11434/api/generate。temperature=0、seed=42、num_predict=128、num_ctx=4096、keep_alive=5mで連続要求する。これは比較用の一設定であり、全モデルでの決定性や適性を保証しない。モデルによって早期終了やthinkingの挙動が違うため、生成数とdone_reasonも比較する。
出力の確認と失敗の扱い
1行が1試行のJSONで、ttfc_s、first_thinking_s、client_total_s、generation_tokens_sとサーバーのカウント・時間を保存する。回答断片がなければTTFCはnull、生成時間が0なら速度もnullになる。途中切断やAPIエラーはstatus=errorとして残し、0秒の成功試行へ変換しない。
クライアントは合成のストリーム応答で、断片の読み取り、時間項目、エラー処理を検証した。実際のOllama生成の計測結果ではない。まず5試行で手順を確認し、比較ではウォームアップの扱いを決めたうえで反復を増やす。成功数、中央値、最小・最大を示し、少数試行のp95を精密な指標として扱わない。
メモリは別の計測が必要
このスクリプトはメモリを測らない。Ollamaの実行中モデルAPIでは常駐モデルの情報やsize_vramを確認できるが、それだけではOS全体や一瞬のピークを表さない。OS・GPUの監視ツールで、アイドル時と生成中を一定周期で記録し、観測周期も明示する。
RAMのプロセス使用量、ページキャッシュ、GPU割当量は異なる指標であり、そのまま足すと二重計上になり得る。統合メモリの機器ではさらに境界を確認する。メモリ不足でCPUへ一部処理が移る場合などは、速度だけをモデル能力の差として説明しない。
比較表の完成形
「モデルと量子化/入力・出力token数/常駐とキャッシュ条件/成功数/TTFC中央値/生成速度中央値/総時間/メモリ指標と観測周期」を一行にする。回答の正しさは別に評価する。電力も比較したい場合は自宅サーバーの消費電力測定で、同じ仕事を終えるまでのWhと結び付ける。
現在の項目 · 8 / 8 · 機械学習入門
コメント
コメントの投稿にはログインが必要です
まだコメントはありません。